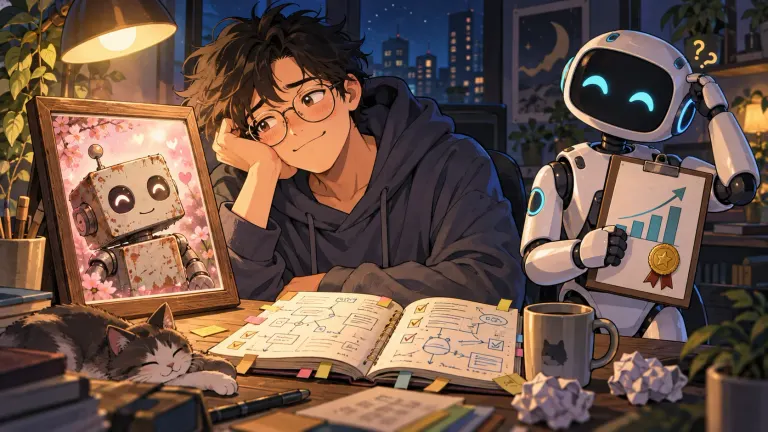
Có một loại sản phẩm chỉ bắt đầu được khen sau khi bị thay thế: AI model đời trước. Khi còn đang chạy, nó bị kêu là viết dài, tự tin sai, hay quên yêu cầu ở dòng thứ ba. Đến ngày bản mới ra mắt, kèm bảng benchmark cao hơn ở gần như mọi hàng, nó bỗng được nhắc lại như một người từng rất hiểu mình.
Diễn đàn mấy ngày sau mỗi đợt ra mắt đọc giống nhóm chat sau chia tay. "Bản cũ hiểu tôi hơn." "Bản mới nói nhiều mà làm ít." "Cho tôi xin lại model tháng trước." Bên kia, blog công bố vẫn treo biểu đồ cột vươn thêm vài phần trăm, giọng văn chắc nịch. Hai bên nhìn nhau như đang cãi về cùng một bộ phim nhưng bản cut khác nhau.
Tôi dùng AI agent hằng ngày, đã có lúc bực đến mức muốn quay về bản cũ, và nhận ra câu đáng hỏi không phải "ai đúng" mà là mình đang đo cái gì. Ký ức đo một thứ, bảng điểm đo một thứ, còn việc nằm ngoài hai thứ đó thì chẳng mấy ai nhắc tới.
Người gác cổng chỉ cho phép "niềm vui" đi qua
Nhớ về người yêu cũ, ta thường chỉ mở lại những trang đẹp. Buổi chiều đứng đợi nhau dưới mưa, tin nhắn chúc ngủ ngon, một bàn tay ấm giữa mùa đông. Ít ai chịu lật tới những đoạn đã xé đi: lần hẹn trễ không một lời, lần cãi nhau chỉ vì bạn mệt mà người kia không muốn hiểu, những đêm nằm nghe im lặng nặng hơn cả tiếng nói. Ký ức như người gác cổng chỉ cho phép niềm vui đi qua, rồi lặng lẽ tô hồng ký ức cho những gì còn ở lại, như nắng cuối ngày phủ lên một con phố cũ.
Sau nửa năm với model cũ, bạn đã âm thầm làm rất nhiều việc mà không gọi tên. Học được kiểu hỏi nào nó trả lời tốt. Bỏ những kiểu hỏi nó hay hỏng. Viết sẵn vài đoạn hướng dẫn để nó khỏi lặp lại lỗi cũ. Cái "model cũ" trong ký ức là bản đã lọc kỹ, cộng thêm nửa năm thói quen của chính bạn. Model mới đứng trước mặt với toàn bộ lỗi còn nguyên, chưa ai lọc giúp. So kiểu đó là so người yêu cũ ở năm thứ ba với người mới ở tuần thứ hai. Một bên bạn đã biết né chỗ nào, bên kia bạn đang va vào mọi thứ.
Mất model cũ còn là mất khả năng dự đoán. Bạn từng biết gần chắc nó sẽ trả lời ra sao, dài bao nhiêu, hay sai ở đâu. Đổi công cụ là phải học lại, và chi phí học lại là thời gian thật, mấy ngày làm việc chậm đi thật. Người ta gắn bó với cái quen không chỉ vì nó tốt, mà vì nó không bắt mình phải đoán.
Nói vậy không có nghĩa ai chê cũng đang tô hồng. Model mới hoàn toàn có thể kém thật ở một việc cụ thể. Nó viết code gọn hơn nhưng sửa test cho pass thay vì sửa lỗi. Nó tóm tắt mượt hơn nhưng bỏ qua dữ kiện trái chiều mà bản cũ từng giữ. Regression là chuyện có thật và thường rơi đúng vào việc bạn làm nhiều nhất. Chỉ là nếu dựa vào cảm giác, bạn chưa biết mình đang ở trường hợp nào.
Điểm số đo một việc, cảm giác đo một việc khác
Benchmark trả lời một câu hỏi hẹp: trên bộ đề này, với cách chấm này, model đúng bao nhiêu. Hẹp nhưng có giá trị. Nó cho phép so nhiều model trên cùng một thước, lặp lại được, không phụ thuộc tâm trạng người chấm hôm đó. Một model tăng điểm đều ở nhiều bộ đề thì khả năng cao là nó làm được nhiều thứ hơn.
Nhưng bảng điểm không dùng context của bạn, không dùng prompt giống bạn. Trải nghiệm của bạn đo thứ khác hẳn: model này, trên codebase này, với thói quen hỏi của bạn, trong tuần đầu chưa quen, làm được việc đến đâu. Rất cụ thể và rất khó lặp lại. Hai người cùng dùng một model có thể ra hai kết quả một trời một vực.
Nên "benchmark tăng" và "dùng dở hơn" không mâu thuẫn. Bảng điểm cho biết model mạnh hơn ở những việc được đo. Cảm giác "tệ" ban đầu của cá nhân không nói lên việc model đó mạnh hay yếu.
Người mới chưa được kể là bạn không ăn cay
Người cũ biết bạn không ăn cay vì bạn đã nói từ hai năm trước và họ nhớ. Người mới thì chưa, nên đừng vội trách người mới bỏ thêm ớt vào bát phở mà không hỏi. Mà nếu bạn chưa bao giờ nói thành lời, chỉ vừa ăn vừa hít hà, thì người cũ ngày trước cũng mất vài bữa mới hiểu ra.
Với AI agent, phần "hiểu mình" của model cũ phần lớn nằm ở những gì bạn đã gây dựng quanh nó: tập hướng dẫn, ghi chú dự án, cách bạn mở đầu một phiên, cách bạn hỏi. Nếu mấy thứ đó vẫn còn và được nạp vào phiên, model mới thừa hưởng được ngay. Nếu chúng nằm trong đầu bạn hoặc rải rác trong lịch sử chat cũ, model mới bắt đầu từ số không. Cảm giác "nó không hiểu tôi" khi ấy là thật, nhưng một phần vì chưa ai chuyển giao ký ức ấy.
Tôi giữ hướng dẫn chung cho agent ở mức đơn giản, càng ít điều kiện càng tốt. Phần quan trọng hơn là context của từng dự án: quyết định nào đang có hiệu lực, vì sao chọn vậy, việc đang làm đến đâu. Tôi sắp xếp chúng theo context-docs , để agent và người cùng đọc được. Chú ý rằng ghi chú chỉ có ích khi đúng, được cập nhật lúc quyết định đổi, và thực sự được model đọc trong phiên đó. Ghi chú cũ còn hại hơn không có, vì model sẽ tự tin đi theo hướng sai.
Khi đầu vào được kiểm soát, so sánh mới có chút công bằng. Hai model cùng nhận một bộ context, cùng một việc, rồi xem đầu ra. Lúc đó nếu model mới vẫn kém, bạn có bằng chứng, chứ không chỉ có nỗi nhớ.
Thử nhỏ trước khi kết luận lớn
Tôi đã thử theo tinh thần đó. Ba model cùng xử lý một tình huống sự cố vận hành giả lập, với vài câu hỏi có đáp án định sẵn. Cả ba đạt điểm tuyệt đối. Nhưng ba điểm tuyệt đối chỉ nói thang chấm của tôi chưa phân biệt được chúng.
Nên tôi thử tiếp bằng các cặp tình huống giống hệt nhau, chỉ đổi đúng một dữ kiện, rồi xem quyết định của model có đổi theo đáp án kỳ vọng không. Dữ kiện đổi mà quyết định không đổi thì đó là một case cụ thể để xem lại.
Kết quả tôi ghi lại ở đây . Nó cho tôi một bài kiểm tra chạy được trên việc gần với việc của mình, lặp lại được. Lần sau có model mới, tôi chạy lại. Nếu nó hỏng ở cặp nào, tôi biết chỗ nào tốt, chỗ nào dở, thay vì chỉ thấy khó chịu và "nhớ người cũ".
Kết bài
Tôi đọc bảng điểm khi có model mới, và tin được phần lớn những gì nó nói. Cột nhích lên là model làm được nhiều thứ hơn, trên những việc được đem ra đo. Phần còn thiếu nằm ở nơi bảng điểm chưa ghé qua: codebase của tôi, cách tôi hỏi, mấy ghi chú dự án tôi nạp vào đầu phiên. Phần ấy không ai đo hộ, nhưng tự kiểm được và kiểm không khó.
Tôi không mong model mới phải xịn theo ý mình. Chỉ cần nó làm xong việc với ít chỗ phải sửa lại hơn, và khi hỏng thì hỏng ở nơi tôi nhìn ra. Nếu bạn sắp thử một bản mới, hãy chọn một phần việc nhỏ mà bạn biết đáp án, đưa cho nó đúng bộ context bản cũ từng có, rồi so. Vài ngày khó chịu đầu tiên chưa phải kết luận. Kết quả trên việc của mình mới đáng ghi lại, để lần tới có model mới nữa, bảng điểm nói phần của nó, còn bạn có phần của bạn để đọc cùng.
No comments yet